Mostrando las entradas con la etiqueta SQL Server. Mostrar todas las entradas

viernes, 12 de agosto de 2022

CONVERT vs FORMAT

Hace poco estaba revisando el código T-SQL de un cliente y le comentaba que resulta un poco complicado el deducir qué formato de fecha se estará devolviendo al usuario cuando utiliza la función CONVERT, por ejemplo:

CONVERT(VARCHAR(10), GETDATE(), 23)

De forma inmediata recordé que existe la función FORMAT que hace mucho más legible el código. Si tomamos como base la expresión que anteriormente mencioné, su versión en FORMAT sería:

FORMAT(GETDATE(), 'yyyy-MM-dd')

Es evidente que es muchísimo más legible, y de manera inevitable me brincó la pregunta, ¿cuál de las dos opciones es mejor? Para responder a esta pregunta he preparado un ejercicio bastante sencillo, pero que nos ayudará a comprender la enorme diferencia.

Comencemos por crear nuestra tabla y llenarla con 500 mil registros:

CREATE TABLE TestFormat(
    Fecha DATETIME2(0)
)
GO
SET NOCOUNT ON
INSERT INTO TestFormat (Fecha)
VALUES (DATEADD(MINUTE, ABS(CHECKSUM(NEWID())) % 15768000, '1992-01-01 00:00:00'))
GO 500000

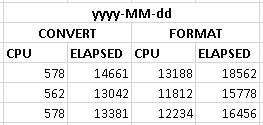
Vamos a comenzar por obtener las fechas en el formato yyyy-MM-dd con CONVERT y tomaremos los tiempos de ejecución.   Para tener una mejor perspectiva, ejecutaremos el ejercicio tres veces.

SET STATISTICS TIME ON
SELECT CONVERT(VARCHAR(10), Fecha, 23)
FROM TestFormat

Y después vamos a obtener el mismo formato pero utilizando la función FORMAT.   Al igual que en el ejercicio anterior, vamos a ejecutarlo unas tres veces para tener más datos de comparación.

SET STATISTICS TIME ON
SELECT FORMAT(Fecha, 'yyyy-MM-dd')
FROM TestFormat

La diferencia en las métricas es muy importante:


Ahora vamos a hacer el mismo ejercicio pero obteniendo la fecha y hora en formato yyyy-MM-dd HH:mm:ss.    Con CONVERT quedaría de la siguiente manera:

SET STATISTICS TIME ON
SELECT CONCAT(CONVERT(VARCHAR(10), Fecha, 23), ' ', CONVERT(VARCHAR(10), Fecha, 24))
FROM TestFormat

Y con FORMAT quedaría de la siguiente manera:

SET STATISTICS TIME ON
SELECT FORMAT(Fecha, 'yyyy-MM-dd HH:mm:ss')
FROM TestFormat

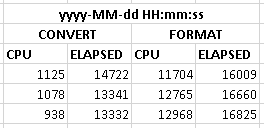
En la imagen siguiente podremos notar que el tiempo de CPU de CONVERT se incrementa y que el tiempo de CPU de FORMAT se mantiene muy parecido:


Pero ni con el incremento de tiempo de CPU en el formato yyyy-MM-dd HH:mm:ss nos acercamos al tiempo de CPU de FORMAT, porque FORMAT se ejecuta casi 10 veces más lento cuando incluimos la hora y casi 20 veces más lento cuando únicamente tenemos la fecha.

¿Qué factores debemos tomar en cuenta para entender estos datos?
  1. FORMAT está implementada a través de un ensamblado de .NET, es decir que se está ejecutando de forma externa.
  2. CONVERT se va al doble cuando hay que incluir la hora porque podemos ver que hay dos ejecuciones de la función, una para obtener la fecha y otra para obtener la hora.
La recomendación que te puedo hacer, es que en el código incluyan un comentario donde se indique el formato de fecha que se estará obteniendo, por ejemplo:

--yyyy-MM-dd HH:mm:ss
SELECT CONCAT(CONVERT(VARCHAR(10), Fecha, 23), ' ', CONVERT(VARCHAR(10), Fecha, 24))
FROM TestFormat

De esta forma será mucho más sencillo el darle mantenimiento al código porque podremos ver de forma inmediata lo que se está obteniendo.   La programación considerada no es una buena práctica, es una obligación.

Espero te haya resultado útil esta entrada.

sábado, 30 de enero de 2021

Login failed for user 'X'


Hace bastante tiempo que no venía por aquí para compartir otra entrada en relación a SQL Server o .NET. Pero en esta ocasión la situación lo amerita, debido que un cliente me pidió solucionar un problema de conexión que jamás había visto en 18 años y me gustaría compartir lo que he ido haciendo para encontrar la solución.

Problema: No te puedes conectar con el SSMS a la instancia local utilizando autenticación de SQL Server, el mensaje que devuelve al momento de conectarse es el famosísimo:

Login failed for user 'X' (Microsoft SQL Server, Error: 18456)

Si abres la ventana para obtener mayor información del error te muestra:

Server Name: .
Error Number: 18456
Severity: 14
State: 1
Line Number: 65536

Y si vas al archivo ErrorLog de la instancia te encuentras algo así:

Logon       Error: 18456, Severity: 14, State: 8.
Logon       Login failed for user 'X'. Reason: Password did not match that for the login provided. [CLIENT: <local machine>]

Antes de que comiences a pensar en lo que podría ser, te comparto la configuración verificada:
  1. Autenticación de SQL Server habilitada en la instancia y ésta ya fue reiniciada en cuanto fue aplicado el cambio.
  2. Ya se verificó que la contraseña sea correcta, inclusive estableciendo la contraseña en el login copiando su valor desde un bloc de notas.
  3. Debido a que la conexión es local, ya se verificó que el protocolo Shared Memory esté habilitado.
  4. Service Pack 4 instalado sobre la instancia (SQL Server 2012) y aplicado también en el SQL Server Management Studio.
Pruebas que ya se realizaron y su resultado:
  1. Conexión local utilizando sqlcmd y con autenticación de SQL: la conexión fue exitosa.
  2. Conexión remota con SQL Server Management Studio y autenticación de SQL: la conexión fue exitosa. 
Con todo lo anterior podemos saber que el problema no es la autenticación debido a que sí se ha podido establecer una conexión tanto local como remota con autenticación de SQL Server.    El único lugar donde está fallando la conexión es en el SSMS local, ya se intentó por ".", "localhost" y por dirección IP, y el resultado siempre es el mismo.

Para poder averiguar un poco más de lo que podría estar haciendo el SSMS al momento de intentar iniciar la conexión con autenticación de SQL Server, utilizamos el procmon de sysinternals pero nada de lo que encontramos ayudó a intentar identificar el problema.

Releí el mensaje de error que se almacena en el archivo ErrorLog de la instancia y encontré algo extraño, que está reportando que la contraseña no es correcta para el login.    Lo que me parece súper extraño por lo siguiente:
  • Si la contraseña la copio desde un bloc de notas y la pego en la línea de comandos con el sqlcmd, sí se conecta.
  • Si la contraseña la copio desde un bloc de notas y la pego en la caja de texto de contraseña del SSMS, ¡no conecta!
La siguiente prueba que se me ocurrió fue cambiarle la contraseña al login "X" y ponerle una contraseña vacía, ¿y qué crees?, ¡SÍ CONECTÓ DESDE EL SSMS!

Lo anterior me lleva a pensar que por alguna muy extraña razón (y me parece extraña porque al momento de escribir esto la desconozco) la contraseña escrita en la caja de texto de la pantalla de ingreso del SSMS, está siendo alterada de alguna manera antes de llegar a SQL Server.

Para no dejar algo de lado y sin probar, se me ocurrió hacer un programa que pidiera servidor, usuario y contraseña para conectarse, en los framework 2.0, 3.5, 4 y 4.5.   Todas las pruebas fueron exitosas.

No encontré alguna referencia del lenguaje de programación utilizado para el SSMS 2012, no sé si fue hecho en C++ o en el .NET Framework.    Pero para verificar que no solamente fuera local el problema, generé un login en otro servidor de base de datos de pruebas y que está expuesto a la internet, hice la prueba de conexión ¡y no conectó!, el error reportado en el otro servidor es el mismo: Password did not match that for the login provided.

Esto comienza a preocuparme un poco más de lo normal, primero por la incertidumbre de no saber lo que está sucediendo, y segundo porque la contraseña que escribes en la caja de texto no es la misma que le está llegando al servidor destino, ¿habrá sido comprometido el servidor?, lo revisaré más a fondo para ver si encuentro algo extraño (sí, más)

En cuanto tenga más noticias, regresaré a actualizar esta entrada.

Se realizó una revisión de componentes del sistema operativo y también se corrió una revisión completa contra malware, ambas operaciones no reportaron problemas.

Lamentablemente, no se encontró otra alternativa que reinstalar el SQL Server Management Studio y el problema dejó de ocurrir.    Y pongo "lamentablemente" porque no me deja satisfecho la solución, pero el tiempo ya se tenía encima y no había forma de seguir investigando para encontrar el problema de raíz.

miércoles, 12 de julio de 2017

ORDER BY


Durante la semana pasada estaba de visita con un cliente y me encontré con un tema que resulta muy interesante, los conjuntos de resultados ordenados.

Cuando uno ejecuta una sentencia en SQL Server sin utilizar ORDER BY, los resultados son contemplados como conjuntos de datos, éstos no tienen un orden bien definido, son simplemente conjuntos donde sus datos satisfacen las características de los predicados utilizados en las sentencias.

Si utilizas el ORDER BY, entonces lo que estás solicitando es conocido como CURSOR.   Es importante no confundirlos con los objetos que nos permiten lecturas fila a fila.

Cuando la combinación de las columnas que aparecen en el criterio de ordenamiento no aseguran una combinación única, el orden del resultado no está totalmente asegurado, esto se debe a que varias formas de ordenar el mismo resultado cumplirían con los criterios de ordenamiento.

Para explicar mejor este punto vamos a realizar un ejercicio bastante sencillo pero que ayudará a entender mejor este tema tan interesante.

Vamos a conectarnos a una base de datos que tengas de pruebas (yo usaré AdventureWorks2014), crearemos una tabla de prueba y la llenaremos con datos aleatorios con el siguiente query.

IF NOT OBJECT_ID('dbo.TestOrderTORAB') IS NULL
    DROP TABLE dbo.TestOrderTORAB
GO
CREATE TABLE dbo.TestOrderTORAB(
    Id INT IDENTITY(1, 1),
    Nombre VARCHAR(32) NOT NULL,
    Color VARCHAR(8) NOT NULL,
    CONSTRAINT pkTestOrderTORAB PRIMARY KEY (Id)
)
GO
DECLARE @i INT = 1
WHILE @i <= 500
BEGIN
    INSERT INTO dbo.TestOrderTORAB (Nombre, Color) VALUES (REPLACE(CAST(NEWID() AS VARCHAR(36)), '-', ''), 'Amarillo')
    INSERT INTO dbo.TestOrderTORAB (Nombre, Color) VALUES (REPLACE(CAST(NEWID() AS VARCHAR(36)), '-', ''), 'Blanco')
    INSERT INTO dbo.TestOrderTORAB (Nombre, Color) VALUES (REPLACE(CAST(NEWID() AS VARCHAR(36)), '-', ''), 'Rojo')
    INSERT INTO dbo.TestOrderTORAB (Nombre, Color) VALUES (REPLACE(CAST(NEWID() AS VARCHAR(36)), '-', ''), 'Azul')

    SET @i += 1
END


En una nueva conexión (ventana) ejecuta la siguiente sentencia.    Es importante mencionar que tu resultado y mi resultado serán muy diferentes, esto es debido a que la tabla fue poblada con información aleatoria.   Aquí lo importante es que veas en tu resultado las filas que forman parte de él.

SELECT TOP 10 Id, Nombre, Color FROM dbo.TestOrderTORAB ORDER BY Color


Supongamos que por tareas de optimización se vio la necesidad de crear un índice sobre la tabla TestOrderTORAB.    Ejecuta este query en otra ventana para que no pierdas el resultado de la sentencia que anteriormente ejecutamos.

CREATE INDEX ixTestOrderTORAB ON dbo.TestOrderTORAB (Color, Nombre)

Si abrimos otra ventana y volvemos a ejecutar la misma sentencia que obtiene los 10 primeros productos ordenados por color, ¡veremos que es diferente el resultado!


Esto a pesar de que es el mismo query y que los datos de la tabla no han sido modificados.    ¿Cuál es la razón?, que el plan de ejecución con el que se despachó el query cambió de uno a otro y que la condición de tomar los primeros 10 productos ordenados por color sigue siendo cumplida con un conjunto de resultados diferente.


Ambos resultados son correctos, y la razón es que ambos cumplen con devolver los primeros 10 elementos que SQL Server encontró ordenándolos por nombre.

Si deseamos que esto no suceda, es necesario incluir una columna que ayude a que sea única la combinación de valores de las columnas utilizadas en el ORDER BY, a esta columna se le conoce como tiebreaker.

Vamos a eliminar el índice con la siguiente sentencia:

DROP INDEX ixTestOrderTORAB ON dbo.TestOrderTORAB

Modificamos el query para incluir la columna id como tiebreaker y ejecutamos para observar los resultados:

SELECT TOP 10 Id, Nombre, Color FROM dbo.TestOrderTORAB ORDER BY Color, Id


Creamos de nueva cuenta el índice con la siguiente sentencia:

CREATE INDEX ixTestOrderTORAB ON dbo.TestOrderTORAB (Color, Id, Nombre)

Ejecutamos el mismo query (el que tiene id como tiebreaker) en otra ventana y veremos que el resultado es el mismo.   No importa que se haya creado un índice, el resultado no fue modificado y la razón es que la combinación de valores de las columnas utilizadas en el ORDER BY es única.

Si comparamos los planes de ejecución de ambas sentencias (antes del índice vs después del índice) veremos que cambió, lo cual es totalmente deseable cuando uno genera índices, que éstos sean contemplados por el optimizador de consultas para mejorar el rendimiento.

En conclusión, es muy recomendable incluir una columna tiebreaker en caso de que la combinación de valores de las columnas utilizadas en un ORDER BY no sean únicos.

Espero esta entrada te haya gustado y te ayude a mejorar en tu trabajo.   Te espero en la siguiente, ¡saludos!


martes, 5 de mayo de 2015

Incorrect syntax near 'go'


El día de hoy me encontré con que un compañero estaba sufriendo bastante para crear un programa en .NET (aplicación de escritorio) que instalara una base de datos, desde su aprovisionamiento hasta la inicialización.

Al revisar el código que estaba utilizando, me encontré que los comandos en el archivo de recursos incluían la palabra GO.

Antes de abordar una solución simple, me gustaría explicar para qué sirve la palabra reservada GO en una sentencia SQL.

Vamos a abrir la página de opciones del SQL Server Management Studio:


Notemos que la opción "Batch separator" tiene el valor GO.    De ello podemos deducir que es una opción de configuración para SQL, de manera tal que en un sólo script podamos meter varias sentencias sin que una interfiera con la otra.    La palabra reservada GO no hace más que decir que ya terminó la sentencia y que la sentencia posterior es totalmente independiente a la anterior.

Vamos a probar esto con un ejemplo muy sencillo:

DECLARE @CurrentTime DATETIME = GETDATE()
PRINT @CurrentTime
GO
PRINT @CurrentTime


El resultado será el siguiente:


La primera sentencia PRINT sí se está ejecutando de forma exitosa, pero la segunda está marcando un error, y esto se debe a que la palabra reservada GO hace un "borrón y cuenta nueva", de manera tal que la variable @CurrentTime ya no existe en la segunda sentencia PRINT.

Debido a esto, el query que está ocupando mi compañero, está marcando el mensaje de error "Incorrect syntax near 'GO'"

Lo que menos se quería era tener que modificar el script para poder instalar la base de datos, por lo que encontramos una solución muy sencilla, crear una función que recibiera el script completo (con todo y GO) y lo dividiera en varios scripts tal como hipotéticamente se hace en SQL Server cuando se ejecuta, y el resultado fue el siguiente:

static void ExecuteCommand(string sqlCommandText, SqlConnection conn)
{
  SqlCommand comm = new SqlCommand("", conn);
  foreach (string sqlCommand in sqlCommandText.Split(new string[] { "GO\r\n" }, StringSplitOptions.RemoveEmptyEntries))
  {
    comm.CommandText = sqlCommand;
    comm.ExecuteNonQuery();
  }
}


Nuestra función aparte recibe una conexión abierta y disponible para ser utilizada.

Podemos notar que lo único que se está haciendo es dividir el script completo en pedazos ejecutables desde .NET.

La solución es sumamente simple, no hubo que ajustar nada en el código del script y la instalación de la base de datos ya tiene un resultado exitoso.

Espero te haya resultado de utilidad, nos vemos la siguiente entrada.

jueves, 30 de abril de 2015

Covering indexes


Los índices de cobertura, son aquellos que nos ayudan a mejorar el rendimiento de ciertas consultas que utilizan un índice y que cuyo resultado incluye un mismo conjunto de columnas.

Tal como en las anteriores entradas, vamos a aterrizar esto en un ejercicio para que se vea la utilidad de estos elementos.

Tomaremos la base de datos AdventureWorks como ejemplo y partiremos del siguiente query:

SELECT ProductID, Name, ProductNumber, MakeFlag
FROM Production.Product
WHERE Color = 'White'


Si revisamos el plan de ejecución, notaremos que se está llevando a cabo un barrido del CLUSTERED INDEX de la tabla Production.Product:


Con un costo estimado de 0.0127253, el cual ciertamente es bastante bajo, pero esto se debe a la poca cantidad de elementos que tiene nuestro conjunto.

¿Qué es lo primero que haríamos para mejorar el rendimiento de esta consulta?, claro, irnos a la parte del WHERE y analizar el predicado.    Después de revisarlo podemos proponer un índice sobre la columna Color de la tabla Production.Product.

CREATE INDEX ixColor
ON Production.Product (Color)


Vamos a revisar nuevamente nuestro plan de ejecución:


Notaremos que hay un cambio importante, ahora se está realizando una búsqueda en el índice ixColor, justamente el que acabamos de crear.    Notemos también que se está llevando a cabo una tarea Key Lookup que sirve para encontrar las columnas que nos faltan para poder dar el resultado, las cuales son ProductID, Name, ProductNumber y MakeFlag.

El costo de este query cambió de 0.0127253 a 0.0126079, lo cual significa una variación menor al 1%, en verdad que no es nada impresionante si lo comparamos contra el costo que tendrá para la base de datos el mantener al día este nuevo índice respecto a los cambios que sufra la tabla a la que apunta.

Pero bueno, tomemos en cuenta que tenemos sólo 504 filas en la tabla de productos, también es por ello que la variación es tan pequeña.

Ahora, vamos a ahondar un poco más en el Key Lookup:


Nuestro índice ixColor, sólo guarda los valores del Color y una liga hacia la tabla Production.Product donde se almacena la fila a la que pertenece, de ahí que se tenga que hacer ese Key Lookup para encontrar los datos que le hacen falta al query para devolver el resultado completo.     Notemos que en la imagen aparecen en Output List Name, ProductNumber y MakeFlag.

¿Qué pasa si siempre regresamos las mismas columnas?, ¿qué pasa si este query regresa un subconjunto de columnas que habitualmente se ocupan?    Si este es el caso, estamos ante la perfecta opción de utilizar un índice de cobertura (covering index)

¿Qué es un covering index?, es aquel que almacena también los valores que forman parte del resultado, es decir, que ya no debe de ir a la tabla original por ellos dado que tiene una copia actualizada en él.

Vamos a crearlo:

CREATE INDEX ixColorCovering
ON Production.Product (Color)
INCLUDE (Name, ProductNumber, MakeFlag)


Y analicemos nuevamente el plan de ejecución para ver los cambios:


Podemos notar que ahora se está utilizando únicamente nuestro índice ixColorCovering.    ¿Qué costo tiene actualmente el query?, el costo es de 0.0032864, lo cual significa una mejora del 74.17%.

¿Qué tal?, ahora sí impresiona ¿no?, y eso que estamos hablando de una tabla con 504 filas, ahora imagina que estuviéramos trabajando en una tabla con miles o millones de filas, verás dos impactos mayúsculos:
  1. Tiempo de respuesta muchísimo menor.
  2. Menor uso de memoria de SQL Server para poder despachar el resultado.
Antes de dar por finalizada esta entrada, quisiera remarcar lo siguiente: cuidado con los índices, recuerda que cada vez que generas un nuevo índice, SQL debe actualizar su valor si es que el valor original en la tabla fue alterado, esto significa que una simple escritura se puede traducir en muchas más.

Espero te haya resultado de utilidad esta entrada, nos vemos la siguiente.

jueves, 12 de diciembre de 2013

Read uncommitted


En esta entrada exploraremos cómo funciona el nivel de aislamiento READ UNCOMMITTED.

Antes de comenzar el ejercicio quisiera hacer notar que el nivel de aislamiento por defecto de SQL Server es READ COMMITTED, esto implica que no podemos leer la información sino hasta que ésta ha sido actualizada de forma definitiva (committed) en la base de datos o bien los cambios han sido deshechos a través de un rollback.

Por ejemplo, supongamos que la transacción 1 ejecuta la siguiente instrucción:
USE AdventureWorks GO BEGIN TRAN UPDATE Production.Product SET ListPrice += 1 WHERE ProductID = 1

Notamos que la transacción queda "abierta", es decir que no ha sido confirmada hacia la base de datos (committed) o deshecha (rollback), por lo tanto SQL Server mantendrá el bloqueo de tipo exclusivo sobre el producto cuyo id sea 1.

En otra ventana ejecutaremos la siguiente sentencia:
USE AdventureWorks GO BEGIN TRAN UPDATE Production.Product SET ListPrice += 1 WHERE ProductID = 1

Veremos que este query queda en espera debido a que el nivel de bloqueo que él requiere (READ COMMITTED) no le permite obtener la información que necesita debido a que la transacción 1 no ha finalizado. La transacción 1 tiene un bloqueo exclusivo que no es compatible con READ COMMITTED de otra transacción.

Esta información la podemos confirmar con la siguiente sentencia:
USE AdventureWorks GO SELECT DB_NAME(T.resource_database_id) AS database_name, OBJECT_NAME(P.[object_id]) FROM sys.dm_tran_locks T INNER JOIN sys.partitions P ON T.resource_associated_entity_id = P.hobt_id WHERE T.request_mode = 'X'

Veremos que se tiene un bloqueo exclusivo sobre algún elemento del objeto Production.Product. También se podría obtener la fila que está siendo bloqueada, pero perderíamos el enfoque de esta entrada.

Volvamos a la ventana de la transacción 1 y ejecutemos COMMIT, veremos que de forma casi inmediata la transacción 2 será desbloqueada y podrá obtener los datos que requiere.

¿Qué pasa cuando la información que queremos obtener es "inmutable"?, no quisiera utilizar la palabra inmutable en su totalidad debido a que en teoría los únicos datos inmutables de una base de datos son las llaves primarias, pero podemos suponer que el nombre de un producto es inmutable, sería muy extraño tener que actualizar el nombre de un producto. En este caso no requerimos que alguna otra transacción genere algún bloqueo sobre la lectura del Id y del Nombre del producto, por lo tanto, necesitamos leer los datos independientemente de los cambios que se estén realizando sobre ellos.

Antes de hacer cambios en el código, vamos a la ventana de la transacción 2 y ejecutamos COMMIT para no dejar transacciones abiertas (colgadas) en el manejador de bases de datos.

Volvamos a ejecutar el código de la transacción 1 para generar un bloqueo sobre el producto cuyo Id es 1, y vamos a cambiar un poco el código de la transacción 2:
SET TRANSACTION ISOLATION LEVEL READ UNCOMMITTED BEGIN TRAN SELECT ProductID, Name, ListPrice FROM Production.Product WHERE ProductID = 1

Podemos notar que ahora estamos estableciendo el nivel de aislamiento en READ UNCOMMITTED para poder leer datos que no han sido hechos "oficiales" en la base de datos. Si ejecutamos la transacción veremos que la información del nombre, producto y precio son inmediatamente devueltos.

Hasta ahora todo parecería que salió tal como lo deseamos, pero... ¿qué pasaría si necesitáramos realizar alguna acción tomando el precio del producto?, he ahí que vendría un fenómeno conocido como "dirty reads", eso quiere decir que podríamos leer un valor que no ha sido hecho oficial sobre la base de datos y que posiblemente su cambio pudiera ser deshecho, es decir que operaríamos con un valor que jamás debió ser tomado.

¿Qué debemos hacer?, dependerá de la operación y de los valores que queremos utilizar, deberemos establecer categorías de los datos que requieren un bloqueo exclusivo y también identificar los datos que pueden ser leídos durante una transacción de actualización.

Espero te haya resultado de utilidad esta entrada, nos vemos la siguiente.

miércoles, 11 de diciembre de 2013

Refrescando los metadatos de una vista


En esta entrada mostraré un fenómeno que se da cuando no establecemos de forma explícita las columnas que queremos devolver en una vista.

Comenzaremos creando una tabla, metiéndole datos y creando una vista que mostrará el contenido de toda la tabla:
CREATE TABLE Test( Id INT IDENTITY(1, 1), Value VARCHAR(10) ) GO INSERT INTO Test (Value) VALUES ('Valor 1'), ('Valor 2'), ('Valor 3') GO CREATE VIEW vTest AS SELECT * FROM Test GO SELECT * FROM vTest

Veremos que el resultado de la consulta a la vista nos devolverá el contenido completo de la tabla (tal como lo esperábamos):

Ahora vamos a modificar la estructura de nuestra tabla para agregar una columna calculada que muestre la primera letra de la columna Value:
ALTER TABLE Test ADD FirstLetter AS SUBSTRING(Value, 1, 1) PERSISTED

Ahora vamos a ejecutar un query que muestre todo el contenido de la tabla y también que muestre todo el contenido de la vista:

Notemos que la primera sentencia que trabaja sobre la tabla muestra las tres columnas que conforman al objeto, mientras que la segunda sentencia sólo muestra dos columnas, las columnas que existían en la tabla durante el momento de la creación de la vista. ¿Qué es lo que está pasando?, que los metadatos de la vista siguen siendo los mismos, es por ello que aunque cambió la definición de la tabla, la vista sigue utilizando las mismas columnas que antes.

La forma de corregirlo es a través del procedimiento almacenado sp_refreshview:
sp_refreshview 'vTest' GO SELECT * FROM vTest

Notemos que ahora ya se están mostrando las tres columnas que forman parte de la tabla.

Aunque te muestro cómo corregir este problema, no es nada recomendable utilizar un query del tipo SELECT * FROM Table porque se estará ignorando cualquier índice que haya sido creado sobre la tabla para optimizar su lectura.

Espero esta entrada te haya resultado de utilidad, nos vemos la siguiente.

martes, 10 de diciembre de 2013

Limpiar historial de respaldos


En esta entrada muy corta pero sumamente útil, te mostraré cómo eliminar el historial de copias de respaldo que se acumula en la base de datos msdb a lo largo del tiempo.

Comenzaré explicándote que no importa cómo saques el respaldo de tu base de datos, el historial de haberlo hecho se guarda, haya sido un respaldo de tipo Full, Log, Differential o de cualquier otro tipo.

Es común que en servidores que tengan implementado un esquema de Log Shipping, el tamaño de la base de datos msdb se dispare, esto se debe a que la cantidad de respaldos aumenta por la naturaleza propia de este esquema de alta disponibilidad y por lo tanto el historial de respaldos se incrementa.

Antes de limpiar el historial de respaldos es importante sacar un respaldo de la base de datos msdb, esto es para poder tener evidencia clara de las operaciones que se realizaron y en caso de una auditoría podamos demostrar que se hicieron los respaldos en tiempo y forma. También puede servirnos para demostrar que no se hicieron los respaldos, a veces la gente encargada de esta pequeña parte de la operación se le va el avión y no revisa que los respaldos se hayan ejecutado de forma correcta.

Si quisiéramos eliminar todo el historial de respaldos bastaría con utilizar el siguiente código:
DECLARE @Today DATETIME = GETDATE() EXEC msdb.dbo.sp_delete_backuphistory @Today

Veamos que el procedimiento almacenado sp_delete_backuphistory recibe como parámetro la fecha más antigua que se guardará en el historial de respaldos, eso implica que todo registro histórico de respaldo que se haya creado antes de esa fecha ya no estará almacenado en msdb.

Si se sacara un respaldo cada 30 días de la base de datos msdb, bien podríamos estar limpiando el historial de la siguiente manera:
DECLARE @MonthAgo DATETIME = DATEADD(DAY, -30, GETDATE()) EXEC msdb.dbo.sp_delete_backuphistory @MonthAgo

Espero esta entrada te haya resultado útil, nos vemos la siguiente.

lunes, 9 de diciembre de 2013

IDENTITY vs SCOPE_IDENTITY()


En esta entrada exploraremos la diferencia entre estas dos funciones del sistema que mucha gente utiliza y que es sumamente importante conocer el valor que están devolviendo.

Comenzaremos creando dos tablas, en una agregaremos valores y la otra servirá para llevar un historial muy sencillo de movimientos:
CREATE TABLE TestIdentity( Id INT IDENTITY(1, 1), Value VARCHAR(10) NOT NULL ) GO CREATE TABLE TestIdentityLog( Id INT IDENTITY(1, 1), Task VARCHAR(10), Value VARCHAR(10) )

En la tabla TestIdentity iremos guardando valores de prueba y la tabla TestIdentityLog estará guardando el historial de movimientos que se han llevado a cabo sobre la tabla TestIdentity. Debemos notar que en las dos tablas tenemos una columna IDENTITY.

Ahora vamos a crear dos triggers, uno para el INSERT y otro para el DELETE:
CREATE TRIGGER TestIdentity_Insert ON TestIdentity FOR INSERT AS BEGIN INSERT INTO TestIdentityLog (Task, Value) SELECT 'INSERT', Value FROM INSERTED END GO CREATE TRIGGER TestIdentity_Delete ON TestIdentity FOR DELETE AS BEGIN INSERT INTO TestIdentityLog (Task, Value) SELECT 'DELETE', Value FROM DELETED END

Ambos guardan el movimiento en la tabla de historial, sólo que el primero es para INSERT y el segundo para DELETE

Vamos a crear un procedimiento almacenado para agregar un valor a TestIdentity, de paso mostraremos el resultado de la ejecución de los dos valores que nos interesan: @@IDENTITY y SCOPE_IDENTITY():
CREATE PROC pAddValue( @Value VARCHAR(10) ) AS BEGIN INSERT INTO TestIdentity (Value) VALUES (@Value) PRINT '@@IDENTITY: ' + CAST(@@IDENTITY AS VARCHAR) PRINT 'SCOPE_IDENTITY(): ' + CAST(SCOPE_IDENTITY() AS VARCHAR) END

Ahora vamos a crear un procedimiento almacenado que nos permita eliminar un elemento de la tabla TestIdentity:
CREATE PROC pDeleteValue( @Id INT ) AS BEGIN DELETE TestIdentity WHERE Id = @Id END

Habitualmente se piensa que podemos utilizar cualquiera de los dos sin problema, pero al ejecutar el siguiente código veremos que ambas nos mostrarán números diferentes en la tercera ejecución:
SET NOCOUNT ON GO EXEC pAddValue 'Valor 1' GO EXEC pDeleteValue 1 GO EXEC pAddValue 'Valor 1'

El primer EXEC mostrará que @@IDENTITY devuelve 1 y SCOPE_IDENTITY() devuelve 1, pero veremos que el tercer EXEC mostrará que @@IDENTITY devuelve 3 y SCOPE_IDENTITY() devuelve 2.

Esto se debe a que @@IDENTITY devuelve el último valor obtenido a través de una columna IDENTITY, este valor pertence a la columna Id de la tabla TestIdentityLog, los trigger que se están disparando ante el INSERT o DELETE son los que están realizando esa inserción y por lo tanto el último valor asignado es el de la tabla TestIdentityLog.

La función SCOPE_IDENTITY() devuelve el último valor asignado por IDENTITY en el entorno actual de ejecución, para nuestro procedimiento pAddValue el único IDENTITY que tiene a su alcance es el que está en la columna Id de la tabla TestIdentity, es por ello que devuelve el valor 2.

Como podrás notar, es importante conocer la diferencia entre las dos opciones que tenemos, dependerá del objetivo del procedimiento o de la operación cuál te resulte adecuado a tus necesidades; generalmente utilizarás SCOPE_IDENTITY()

Espero esta entrada te haya resultado útil, nos vemos la siguiente.

martes, 3 de diciembre de 2013

Índices y memoria


Habitualmente se piensa que el resultado positivo de un índice sólo se traduce en una lectura más rápida de datos. En esta entrada demostraré que también nos ayudan a reducir el uso de memoria al cargar menos páginas en el buffer de SQL Server.

Recordemos que SQL Server coloca en memoria los datos antes de poder despacharlos, esto se hace de esa forma para que la futura lectura de los datos sea mucho más rápida y no tenga que ir hasta los dispositivos de almacenamiento para recuperar la información.

Quiero hacer un ejercicio muy sencillo pero significativo con la base de datos AdventureWorks. El objetivo es obtener el total de ventas de los productos de color rojo. Analizaremos la cantidad de páginas que se cargan en memoria para poder despachar el resultado.

Nuestro query queda de la siguiente manera:
SELECT SUM(SOD.LineTotal) AS Total FROM Sales.SalesOrderDetail SOD INNER JOIN Production.Product P ON SOD.ProductID = P.ProductID WHERE P.Color = 'Red'

Para obtener la cantidad de páginas que está utilizando nuestra base de datos AdventureWorks en memoria, podemos conectarnos a ella y ejecutar el siguiente query:
SELECT COUNT(*) AS paginas_usadas FROM sys.dm_os_buffer_descriptors WHERE database_id = DB_ID()

Comenzaremos limpiando la memoria y verificando que no se estén usando páginas por parte de la base de datos AdventureWorks:
USE AdventureWorks GO CHECKPOINT DBCC DROPCLEANBUFFERS GO SELECT COUNT(*) AS paginas_usadas FROM sys.dm_os_buffer_descriptors WHERE database_id = DB_ID()

Vamos a ejecutar el query que obtiene el total de ventas de los productos de color rojo y verificamos de nueva cuenta la cantidad de páginas utilizadas por la base de datos AdventureWorks:
SELECT SUM(SOD.LineTotal) AS Total FROM Sales.SalesOrderDetail SOD INNER JOIN Production.Product P ON SOD.ProductID = P.ProductID WHERE P.Color = 'Red' GO SELECT COUNT(*) AS paginas_usadas FROM sys.dm_os_buffer_descriptors WHERE database_id = DB_ID()
En mi caso la cantidad de páginas usadas es de 772

Ahora vamos a crear un índice que nos ayude a optimizar el query, éste será creado sobre la columna ProductID e incluirá las columnas UnitPrice, UnitPriceDiscount y OrderQty las cuales son utilizadas para calcular LineTotal. Nuestro código queda de la siguiente manera:
CREATE INDEX ixSProductID ON Sales.SalesOrderDetail (ProductId) INCLUDE (UnitPrice, UnitPriceDiscount, OrderQty)

Volvemos a limpiar la memoria, ejecutamos nuestro query y verificamos la cantidad de páginas utilizadas por la base de datos AdventureWorks:
CHECKPOINT DBCC DROPCLEANBUFFERS GO SELECT SUM(SOD.LineTotal) AS Total FROM Sales.SalesOrderDetail SOD INNER JOIN Production.Product P ON SOD.ProductID = P.ProductID WHERE P.Color = 'Red' GO SELECT COUNT(*) AS paginas_usadas FROM sys.dm_os_buffer_descriptors WHERE database_id = DB_ID()
En mi caso la cantidad de páginas usadas es de 251

Notemos que la memoria necesaria para despachar el query se redujo en un 67.48%. ¿Qué debemos notar?, que los índices no sólo reducen el tiempo que tarda un query en ejecutarse sino también la cantidad de páginas que SQL Server necesita colocar en memoria para despachar el resultado.

Espero les haya resultado de utilidad esta entrada, nos vemos en la siguente.

miércoles, 10 de julio de 2013

SQL Server SARG


En la mayor parte de los proyectos de consultoría en los que he trabajado, me he encontrado que los predicados de las sentencias están mal escritos, o dicho de otra forma no son óptimos.

¿Cuál es el predicado de una sentencia?, es aquel que limita las filas que va a devolver la sentencia.   Para entender mejor este concepto vamos a analizar unos queries sobre la base de datos AdventureWorks.

SELECT ProductId, Name, ListPrice
FROM Production.Product
WHERE Color = 'White'


En este query vamos a obtener los productos que son de color blanco.    Si revisamos un poco su plan de ejecución (Ctrl + L) y colocamos el mouse encima de la operación "Clustered Index Scan" vamos a ver algo como esto:


Si te fijas, el predicado es la parte del WHERE.

Ahora vamos a analizar otro query, uno que nos devuelva todos los productos que pertenezcan a la categoría 2 (Components).

SELECT P.ProductID, P.Name, P.ListPrice
FROM Production.Product P
INNER JOIN Production.ProductSubcategory PS
ON P.ProductSubcategoryID = PS.ProductSubcategoryID
WHERE PS.ProductCategoryID = 2


Vamos a obtener su plan de ejecución y si colocamos el mouse encima de la operación "Clustered Index Scan" sobre el objeto ProductSubcategory.PK_ProductSubcategoryID veremos algo como esto:


El predicado de nueva cuenta es la parte del WHERE.

Una vez que hemos entendido este punto, es importante notar que un predicado mal escrito puede llevarnos a no utilizar los índices que se hayan creado para la optimización de las consultas, es decir que nuestros predicados no sean SARG (Search Argument).

¿Cómo reconocer cuando un predicado contiene non-SARG?, es sencillo, cuando una operación se lleva a cabo sobre las columnas de nuestras tablas, ese predicado no será óptimo.

Por ejemplo, supongamos que queremos obtener todos los productos a los que realizando un 10% de descuento vayan a tener un precio menor a 100 y mayor a 0.    El query normal que escribiríamos sería el siguiente:

SELECT ProductId, Name, ListPrice
FROM Production.Product
WHERE ListPrice * 0.9 < 100
AND ListPrice > 0


Si revisamos su plan de ejecución (costo 0.0127757) y colocamos el mouse encima de la operación "Clustered Index Scan" veremos que el siguiente predicado:


Notemos que el predicado está llevando a cabo una conversión de la columna Production.Product.ListPrice a un tipo de dato NUMERIC(19, 4).

Si es un query que se va a estar utilizando mucho entonces lo lógico sería crear un índice que nos permita obtener la información de forma mucho más rápida:

CREATE NONCLUSTERED INDEX ixPProduct_ListPrice
ON Production.Product (ListPrice)
INCLUDE (ProductId, Name)


En este query sencillo SQL Server podrá utilizar el índice pero nuestra sentencia no está totalmente optimizada.    Veamos de nuevo el plan de ejecución (costo 0.0053521) y observemos el predicado:


Ahora la operación que se está realizando es un "Index Seek" que es mucho mejor que un "Clustered Index Scan", pero la conversión que se está realizando sobre la columna Production.Product.ListPrice le está afectando a nuestro query.    Si recordamos nuestras clases de matemáticas veremos que es lo mismo:

ListPrice * 0.9 < 100

que

ListPrice < (100 / 0.9)

La diferencia en SQL radicará que la operación ya no se va a realizar sobre la columna, sino le vamos a dar un valor fijo (111.11).

Modifiquemos nuestro query para que quede de la siguiente manera:

SELECT ProductId, Name, ListPrice
FROM Production.Product
WHERE ListPrice < 111.11
AND ListPrice > 0


Si vemos el plan de ejecución (costo 0.0051023) y revisamos el predicado, veremos que la operación ya no se está realizando sobre cada fila de nuestro índice, mejora que se ve reflejada en el costo del plan de ejecución.


La mejora no es brutal, pero si estuviéramos hablando de grandes cantidades de información, seguro sería significativa dado que dejaríamos de utilizar recursos del servidor para atender esta sentencia.


Ahora veamos un ejemplo más interesante, supongamos que nos están pidiendo los productos que hayan sido vendidos en la primera semana del año 2003.    Con la función DATEPART podemos obtener el número de semana de una fecha pasándole como primer parámetro WEEK, y con la función YEAR podemos obtener el año de una fecha.    Nuestro query pudiera ser escrito de la siguiente manera:

SELECT P.ProductID, P.Name, SOD.UnitPrice
FROM Production.Product P
INNER JOIN Sales.SalesOrderDetail SOD
ON P.ProductID = SOD.ProductID
INNER JOIN Sales.SalesOrderHeader SOH
ON SOD.SalesOrderID = SOH.SalesOrderID
WHERE DATEPART(WEEK, SOH.OrderDate) = 1
AND YEAR(SOH.OrderDate) = 2003


Si vemos su plan de ejecución podremos saber que el costo es de 1.38725 y que se está haciendo un barrido de la tabla Sales.SalesOrderHeader.

Vamos a crear un índice en la columna OrderDate de la tabla Sales.SalesOrderHeader para ayudar a que nuestra consulta sea más rápida:

CREATE NONCLUSTERED INDEX ixSSalesOrderHeader_OrderDate
ON Sales.SalesOrderHeader(OrderDate)


Si volvemos a obtener el plan de ejecución de nuestro query (costo 0.91095) veremos que la operación del barrido de la tabla Sales.SalesOrderHeader ha cambiado por un barrido del índice que acabamos de crear.

Una operación Scan sobre un índice no es algo que queramos para nuestros planes de ejecución dado que no se estaría explotando al máximo la funcionalidad de los índices.


No se está realizando un uso óptimo del índice debido a que nuestro criterio de búsqueda no es SARG, estamos llevando a cabo una operación fila a fila sobre la columna OrderDate de nuestra tabla.    ¿Cómo podemos corregirlo?, usando las fechas específicas que cubran el rango de la siguiente manera:

SELECT P.ProductID, P.Name, SOD.UnitPrice
FROM Production.Product P
INNER JOIN Sales.SalesOrderDetail SOD
ON P.ProductID = SOD.ProductID
INNER JOIN Sales.SalesOrderHeader SOH
ON SOD.SalesOrderID = SOH.SalesOrderID
WHERE OrderDate >= '20030101'
AND OrderDate <= '20030104'


Si volvemos a revisar el plan de ejecución (costo 0.362978) veremos que el barrido del índice ha cambiado por una búsqueda, es decir un Index Seek, mejora que se ha visto reflejada en el costo de nuestra sentencia:


Como conclusión, cuando no utilizamos SARG no estaremos utilizando las estructuras optimizadas para nuestras consultas o bien le estaremos dando trabajo de más a SQL para poder despachar el resultado.    Hay que evitar en lo posible las operaciones sobre las columnas de la base de datos durante las búsquedas.

Espero esta entrada te sea de mucha utilidad y ayude a que mejores tus consultas.

martes, 9 de julio de 2013

Validando email en SQL


En ocasiones necesitamos verificar que un correo electrónico tenga un formato válido, es decir una bandeja y su dominio respectivos divididos por una arroba.

En esta entrada veremos una forma sumamente simple pero que servirá como punta de lanza para que utilices el potencial que tienen los ensablados del .NET Framework para integrarlos en SQL Server.

Hay que decir y dejar muy claro que no es la panacea para las cosas complicadas de SQL, es simplemente un punto más, una herramienta más que tenemos a la mano para poder utilizar y facilitar nuestro trabajo.

Hacer la función que valide el formato del correo electrónico se podría describir en un proceso muy simple:
  1. Crear la función como estática en .NET.
  2. Crear un objeto ASSEMBLY en nuestra base de datos.
  3. Crear la función que será mapeada hacia un elemento almacenado en el ASSEMBLY.
Creando función en .NET

Vamos a crear un proyecto de tipo Class Library en Visual Studio y eliminaremos el archivo Class1.cs que trae por defecto la plantilla.

Vamos agregar una clase que alojará nuestra función estática que realizará la validación del correo electrónico, el código quedaría de la siguiente manera:

using Microsoft.SqlServer.Server;
using System.Data.SqlTypes;
using System.Text.RegularExpressions;

namespace EmailValidator
{
    public class Validators
    {
        [SqlFunction]
        public static SqlBoolean ValidateEmail(SqlString email)
        {
            return SqlBoolean.Parse(Regex.IsMatch(email.Value, @"^\w+([-+.']\w+)*@\w+([-.]\w+)*\.\w+([-.]\w+)*$").ToString());
        }
    }
}


El atributo SqlFunction que está calificando a la función ValidateEmail le hace saber a SQL Server que ahí hay una función que puede utilizarse.

Debemos manejar tipos de dato de SQL Server, es por ello que la función devuelve un valor de tipo SqlBoolean y recibe una cadena del tipo SqlString los cuales están definidos en el espacio de nombres System.Data.SqlTypes.

La clase RegEx está definida en el espacio de nombres System.Text.RegularExpressions y su función IsMatch devuelve un valor booleano indicando que su primer parámetro cumple con el patrón definido en el segundo parámetro.

Antes de continuar al siguiente paso de esta entrada, deberemos anotar la ruta completa para llegar a nuestra función EmailValidator.Validators.ValidateEmail.

Vamos a compilar nuestro proyecto y deberá generar el DLL con nuestra función incluida.

Debemos validar el framework bajo el que está siendo construido nuestro DLL, si va a ser utilizado en SQL Server 2008 deberá estar compilado en el framework 2.0, en caso que vayamos a utilizarlo en SQL Server 2012 puede estar compilado en el framework 4.0

Crear ASSEMBLY en base de datos

Vamos a obtener la ruta completa para llegar al DLL que acabamos de generar y la utilizaremos para importarlo en nuestra base de datos.

Vamos a abrir un nuevo query que utilice la base de datos de usuario de tu elección, en mi caso tengo una base de datos llamada ExpertsExchange.

USE ExpertsExchange
GO
CREATE ASSEMBLY Validators
FROM 'D:\Personal\Blogger\EmailValidator\EmailValidator\bin\Debug\EmailValidator.dll'
WITH PERMISSION_SET = SAFE


Nuestro assembly se va a llamar Validators y tendrá un conjunto de permisos SAFE, ¿qué significa esto?

SAFE (valor por defecto) es el nivel más recomendado dado que no permite que la función o funciones incluidas en el assembly tengan acceso al sistema de archivos, a la red, a las variables de entorno o al registro de windows.

EXTERNAL_ACCESS le permite al assembly utilizar recursos externos como son archivos, red, variables de entorno y registro de windows.

UNSAFE le permite al assembly utilizar recursos externos tal como lo hace EXTERNAL_ACCESS y aparte le permite al assembly ejecutar código no administrado (código no hecho en .NET)

Crear función mapeada

Ahora vamos a crear una función escalar que reciba como parámetro el correo electrónico que se quiere validar y devuelva un BIT que indique si es válido o no.

La parte interesante es que sólo declararemos la firma de la función, el cuerpo del código ya está definido en nuestro assembly.

USE ExpertsExchange
GO
CREATE FUNCTION udfValidateEmail(
    @Email NVARCHAR(255)
)
RETURNS BIT
AS EXTERNAL NAME Validators.[EmailValidator.Validators].ValidateEmail


Notemos que la firma es como la de cualquier función que crearíamos en SQL Server, la diferencia radica en el código que está después de la especificación del tipo de resultado de nuestra función.

Aun cuando un correo electrónico no lleva caracteres extraños, es imprescindible utilizar NVARCHAR dado que las cadenas que maneja .NET son UNICODE y por lo tanto SQL Server envía NVARCHAR a .NET para que éstas sean manejadas.

¿Cómo saber qué poner en external name?, es fácil:

SQLAssemblyName.[FullNamespace.Class].NETFunctionName


Ahora vamos a probar nuestra función con algunos correos electrónicos tanto válidos como no válidos:

USE ExpertsExchange
GO
SELECT dbo.udfValidateEmail(N'valid@mail.com')
SELECT dbo.udfValidateEmail(N'invalid@mail..com')
SELECT dbo.udfValidateEmail(N'invalid@mail')
SELECT dbo.udfValidateEmail(N'valid@mail.com.mx')


Si recibes un mensaje de error indicando que el .NET Framework está deshabilitado es porque SQL Server no acepta la ejecución de código CLR externo por defecto.    Vamos a habilitarlo con el siguiente código:

sp_configure 'clr enabled', 1
GO
RECONFIGURE


Vuelve a probar la función y verás que el primer y cuarto correos son válidos y el segundo y tercero no lo son.

Espero te haya resultado de utilidad esta entrada, la integración de funciones CLR a SQL Server es un tema apasionante debido a la gran diversidad de soluciones que se pueden implementar via .NET, pero ten mucho cuidado, esta no es la solución a todos nuestros problemas, necesitamos hacer pruebas que demuestren que el uso de recursos y la velocidad de respuesta son las deseadas.

jueves, 4 de julio de 2013

Emails a tabla


En esta entrada quiero mostrar una forma para recibir una lista de correos electrónicos divididos por coma o por punto y coma y separarlos en filas independientes en una tabla, una vez desarrollado el algoritmo crearemos la función que podremos utilizar de forma muy simple en cualquier base de datos.

Para entender plenamente el ejercicio creo muy importante el explicar brevemente cómo operan las diferentes funciones para manejo de cadenas que utilizaremos en el código.

REPLACE(string, stringToFind, stringToReplace)

Esta función reemplaza todas las apariciones de una cadena en específico por la cadena que nosotros queramos.     Por ejemplo, supongamos que queremos sustituir todas las letras "a" con acento por "&aacute;", el código sería el siguiente:

SELECT REPLACE('Me salieron ámpulas por subirme al árbol', 'á', '&aacute;')

CHARINDEX(stringToFind, string[, startIndex])

Esta función busca la primera posición de izquierda a derecha en la que encuentre la cadena stringToFind dentro de string.    El tercer parámetro opcional indica el índice a partir del cual queremos comenzar la búsqueda de la cadena stringToFind.    Por ejemplo, queremos obtener el índice de la primera ",":

SELECT CHARINDEX(',', 'Primero, segundo y tercero')

La función devolverá un valor 0 cuando no haya encontrado la cadena que se estaba buscando.

RTRIM(string) y LTRIM(string)

La función RTRIM elimina todos los espacios en blanco que encuentre a la derecha de la cadena string, es decir, todos los espacios en blanco de relleno que pueda tener la cadena, en inglés encontramos que a esto se le llama trailing spaces.

La función LTRIM elimina todos los espacios en blanco que encuentre al inicio de la cadena string.

La combinación de ambas funciones RTRIM(LTRIM(string)) tiene un resultado como el de la función Trim de un objeto String de .NET

Supongamos que queremos eliminar todos los espacios a la izquierda y a la derecha de una palabra:

SELECT RTRIM(LTRIM('    con espacios antes y después    '))

SUBSTRING(string, startIndex, length)

Esta función extrae length caracteres de la cadena string a partir del caracter startIndex.    Por ejemplo, queremos extraer la palabra "penca" de la siguiente frase:

SELECT SUBSTRING('Grabé en la penca de un maguey', 13, 5)

La palabra "penca" comienza en el caracter número 13 y tiene una longitud de 5.

Es importante notar que en SQL Server las cadenas comienzan con el índice 1, no como en .NET donde comienzan en el índice 0.

Bueno, una vez que tenemos estas funciones en mente comencemos con la programación de nuestra función.

Vamos a comenzar por declarar una variable donde se encuentren los correos electrónicos que recibiriemos como parámetro en la función:

DECLARE @Emails VARCHAR(2000) = 'email1@domain1.com, email2@domain2.com; email3@domain3.com '

Como podrás notar el primer y segundo correo están divididos por una coma mientras que el segundo y tercer correo están divididos por un punto y coma.    También es importante ver que hay un espacio en blanco al final de la cadena.

Esta serie de cosas las puse así para tomar en cuenta posibles errores por parte del usuario al momento de hacerle llegar el parámetro a la función.

Vamos a cambiar los ";" por "," y así esté homogéneo el divisor de correos:

SET @Emails = REPLACE(@Emails, ';', ',')

Vamos a necesitar un par de variables, una que lleve la posición actual de análisis de la cadena de correos y otra que tenga la posición donde se encuentra la ",":

DECLARE @CurrentPos INT = 1
DECLARE @CommaPos INT = CHARINDEX(',', @Emails)


Vamos a crear una tabla temporal para ir guardando los correos, esta tabla será declarada como parte de la firma de nuestra función:

DECLARE @Result TABLE (
    Email VARCHAR(255)
)


El algoritmo es sencillo, mientras siga habiendo "," hay más correos por analizar, debido a ello estableceremos un ciclo WHILE:

WHILE @CommaPos > 0
BEGIN
END


Cuando queramos extraer el correo electrónico, deberemos sacar del caracter @CurrentPos hasta el índice donde se encuentra la "," pero sin incluir la ",".    También recordemos que tenemos que quitar cualquier espacio en blanco al inicio o al final del correo:

INSERT INTO @Result (Email)
VALUES (RTRIM(LTRIM(SUBSTRING(@Emails, @CurrentPos, @CommaPos - @CurrentPos))))


Debemos poner especial atención al tercer parámetro, en .NET generalmente le colocaríamos un -1 pero como en SQL Server la posición del primer caracter es 1, no es necesario realizar ese pequeño ajuste.

Vamos a actualizar nuestras variables de navegación @CurrentPos y @CommaPos:

SET @CurrentPos = @CommaPos + 1
SET @CommaPos = CHARINDEX(',', @Emails, @CurrentPos)


Notemos que en este caso estamos utilizando el tercer parámetro de la función CHARINDEX, esto se debe a que la búsqueda de la "," queremos que se realice después de la que ya habíamos encontrado.

Nuestro WHILE quedaría de la siguiente manera:

WHILE @CommaPos > 0
BEGIN
    INSERT INTO @Result (Email)
    VALUES (RTRIM(LTRIM(SUBSTRING(@Emails, @CurrentPos, @CommaPos - @CurrentPos))))

    SET @CurrentPos = @CommaPos + 1
    SET @CommaPos = CHARINDEX(',', @Emails, @CurrentPos)
END


Al salir del WHILE estaremos en condiciones de obtener el último correo con el siguiente código:

INSERT INTO @Result (Email)
VALUES (RTRIM(LTRIM(SUBSTRING(@Emails, @CurrentPos, LEN(@Emails) - @CurrentPos + 1))))


Nuestro código final debe quedar de la siguiente manera:

DECLARE @Emails VARCHAR(2000) = 'email1@domain1.com, email2@domain2.com; email3@domain3.com '
SET @Emails = REPLACE(@Emails, ';', ',')

DECLARE @CurrentPos INT = 1
DECLARE @CommaPos INT = CHARINDEX(',', @Emails)

DECLARE @Result TABLE (
    Email VARCHAR(255)
)

WHILE @CommaPos > 0
BEGIN
    INSERT INTO @Result (Email)
    VALUES (RTRIM(LTRIM(SUBSTRING(@Emails, @CurrentPos, @CommaPos - @CurrentPos))))

    SET @CurrentPos = @CommaPos + 1
    SET @CommaPos = CHARINDEX(',', @Emails, @CurrentPos)
END

INSERT INTO @Result (Email)
VALUES (RTRIM(LTRIM(SUBSTRING(@Emails, @CurrentPos, LEN(@Emails) - @CurrentPos + 1))))

SELECT * FROM @Result


Una vez que lo hayamos probado y verifiquemos que funciona tal como lo esperábamos, vamos a encapsularlo en una función para poder reutilizarlo:

CREATE FUNCTION udfSplitEmails(
    @Emails VARCHAR(2000)
)
RETURNS @Result TABLE(
    Email VARCHAR(255)
)
AS
BEGIN
    SET @Emails = REPLACE(@Emails, ';', ',')

    DECLARE @CurrentPos INT = 1
    DECLARE @CommaPos INT = CHARINDEX(',', @Emails)

    WHILE @CommaPos > 0
    BEGIN
        INSERT INTO @Result (Email)
        VALUES (RTRIM(LTRIM(SUBSTRING(@Emails, @CurrentPos, @CommaPos - @CurrentPos))))

        SET @CurrentPos = @CommaPos + 1
        SET @CommaPos = CHARINDEX(',', @Emails, @CurrentPos)
    END

    INSERT INTO @Result (Email)
    VALUES (RTRIM(LTRIM(SUBSTRING(@Emails, @CurrentPos, LEN(@Emails) - @CurrentPos + 1))))

    RETURN
END


Ahora se podrá utilizar de la siguiente manera:

SELECT * FROM udfSplitEmails('email1@domain1.com, email2@domain2.com; email3@domain3.com ')

Espero te haya resultado de utilidad esta entrada, es una función que se puede incluso integrar en la base de datos model para que forme parte del machote de una base de datos cuando sea creada en el servidor.
jueves, 4 de abril de 2013

XML a Entidad-Relación


En esta entrada veremos cómo operar con documentos XML en un modelo entidad relación.   Para este objetivo utilizaremos el siguiente documento como fuente de datos:

DECLARE @Doc XML = '
<subcategories>
  <subcategory Name="Bib-Shorts">
    <products>
      <product ProductID="855" Name="Men''s Bib-Shorts, S" ListPrice="89.9900" />
      <product ProductID="856" Name="Men''s Bib-Shorts, M" ListPrice="89.9900" />
      <product ProductID="857" Name="Men''s Bib-Shorts, L" ListPrice="89.9900" />
    </products>
  </subcategory>
  <subcategory Name="Bike Racks">
    <products>
      <product ProductID="876" Name="Hitch Rack - 4-Bike" ListPrice="120.0000" />
    </products>
  </subcategory>
</subcategories>'

Podemos ver que hay un nodo raíz llamado subcategories y que contiene elementos subcategory quienes a su vez contienen a los productos que pertenecen a esa subcategoría.

Si queremos obtener los productos para poder cruzar la información del documento con alguna tabla resultaría muy complicado hacer un parser para obtenre la información que necesitamos.    Por este motivo SQL Server tiene funciones que nos permiten convertir el documento a una estructura entidad relación.

Antes de comenzar con los queries me gustaría mostrar los símbolos básicos del XPath, el cual es el lenguaje de búsqueda en XML:

Símbolo Uso
. Elemento actual
.. Elemento padre
/ Elemento hijo
// Búsqueda secuencial y jerárquica
[ ] Filtro
@ Atributo

Debemos tener en cuenta que la navegación de un documento XML se hace nodo a nodo por lo que es preferible convertirlo primero a una estructura entidad-relación y no estar navegándolo una y otra vez, si es un documento pequeño no le vamos a encontrar mucho problema, pero si fuera un documento muy grande seguro vamos a tener problemas de rendimiento.

Supongamos que queremos obtener todos los productos que trae el documento, comenzaremos con obtener la ruta de navegación que tenemos que seguir para llegar a los elementos que necesitamos, en este caso la ruta es /subcategories/subcategory/products/product.    Esta ruta en particular devolverá todos los nodos cuya ruta coincida con la especificada en la función.

La función .nodes recibe como parámetro una sentencia XPath, construirá una tabla con una columna donde estará colocado cada nodo descubierto por la ruta; para sacar los valores del nodo ocuparemos la función .value de la siguiente manera:

SELECT c.value('@ProductID', 'INT') AS ProductID,
    c.value('@Name'
, 'NVARCHAR(50)') AS Name
FROM @Doc.nodes('/subcategories/subcategory/products/product') AS T(c)


En este query podemos ver en uso la función .nodes para obtener los nodos que tengan la ruta XPath especificada y después ejecutar la función .value sobre cada nodo obtenido para sacar su información.    La función .value recibe dos parámetros, el primero es el elemento que quiero obtener del nodo actual y el segundo es el tipo de dato al que lo voy a convertir en la estructura entidad-relación.

El resultado de la ejecución de este query es el siguiente:


Podemos ver que tomamos todos los nodos product y los colocamos en una estructura entidad-relación.

Ahora vamos a ocupar un filtro para obtener los productos que pertenecen a la subcategoría Bib-Shorts.

SELECT c.value(
'@ProductID', 'INT') AS ProductID,
    c.value(
'@Name', 'NVARCHAR(50)') AS Name
FROM @Doc.nodes('/subcategories/subcategory[@Name="Bib-Shorts"]/products/product') AS T(c)

Podemos ver que lo que cambió fue la ruta XPath que se utilizó como parámetro para la función .nodes, hemos agregado unos corchetes para que filtre los nodos subcategory que cumplan con que su atributo Name sea Bib-Shorts.   A continuación muestro el resultado:


¿Qué pasa si nos piden que mostremos el nombre de la categoría en una tabla que tenga todos los productos del documento XML?, recordemos que tenemos el símbolo ".." para XPath, modifiquemos el query para mostrar lo que nos piden:

SELECT c.value('../../@Name', 'NVARCHAR(50)') AS Subcategory,
    c.value('@ProductID', 'INT') AS ProductID,
    c.value('@Name', 'NVARCHAR(50)') AS Name
FROM @Doc.nodes('/subcategories/subcategory/products/product') AS T(c)


Podemos ver que agregamos una columna más al query donde utilizamos el parámetro ".." para irnos moviendo del nodo actual product hacia el padre dos lugares arriba en la jerarquía del documento.   Aquí está el resultado:


En la entrada siguiente abordaré la función XML .exist y en la entrada posterior veremos la función .query.

Espero te haya sido de utilidad esta entrada.

miércoles, 3 de abril de 2013

Programación en SQL Server - parte 4


En esta entrada veremos cómo utilizar la sentencia MERGE para poder actualizar el contenido de una tabla en base a la comparación contra otra tabla.

Supongamos que tenemos una tabla de productos y que nos envían en un archivo de XML los nuevos datos de los productos, en este archivo XML pueden venir productos nuevos y productos existentes que se desean actualizar.

Hay muchas formas de solucionar este problema, a mí se me ocurre la siguiente (en la forma tradicional):
  1. Cargar el archivo XML a una tabla temporal.
  2. Actualizar los productos que están en la tabla tempora y que existen en la tabla objetivo.
  3. Insertar los productos que están en la tabla temporal pero que no existen en la tabla objetivo.
Este trabajo se puede resolver de una forma mucho más compacta con la instrucción MERGE, dado que dependiendo de la existencia de los elementos en la tabla objetivo podemos realizar tareas de inserción, actualización o eliminación.

Vamos a crear las estructuras que utilizaremos para explicar cómo funciona esta instrucción (no he colocado constraints de tipo UNIQUE ni CHECK para hacer más corto el código):

CREATE TABLE Products(
    Id TINYINT NOT NULL,
    Name VARCHAR(10) NOT NULL,
    ListPrice DECIMAL(8, 2) NOT NULL,
    CONSTRAINT pkProducts PRIMARY KEY (Id)
)

GO
INSERT INTO Products (Id, Name, ListPrice)
VALUES (1, 'Product 1', 10),
    (2, 'Product 2', 20),
    (3, 'Product 3', 30),
    (4, 'Product 4', 40)


Ahora voy a mostrar el XML que estaría recibiendo nuestro procedimiento almacenado para realizar la actualización o inserción de productos:

<products>
    <product id="2" name="new 2" listPrice="22" />
    <product id="4" name="new 4" listPrice="44" />
    <product id="5" name="Product 5" listPrice="50" />
</products>


Podemos notar que los productos 2 y 4 ya existen en nuestra tabla y que el producto 5 no, por lo que el resultado esperado es que los productos 2 y 4 sean actualizados y el producto 5 sea insertado en la tabla.

La sentencia MERGE tiene la siguiente sintaxis (reducida):

MERGE INTO Target T
USING Source S
ON T.Col1 = S.Col1
WHEN MATCHED THEN
    --Sentencia a ejecutarse cuando halle correspondencia entre las filas
WHEN NOT MATCHED THEN
    --Sentencia a ejecutarse cuando no halle correspondencia en la tabla Target
WHEN NOT MATCHED BY SOURCE THEN
    --Sentencia a ejecutarse cuando no halle correspondencia en la tabla Source

He colocado como nombres de tabla Target y Source dado que la tabla Target será el objetivo principal de las actividades a realizarse en base a la comparación entre las filas contra la tabla Source en su columna Col1.

En nuestro caso la tabla Target será Products mientras que la tabla Source será el documento XML que estamos recibiendo como parámetro.

La columna que en nuestro caso estaremos comparando para verificar si hay o no correspondencia será Id.

Voy a escribir el código completo para la declaración de la variable de tipo XML (simulando la recepción del parámetro) y la sentencia MERGE:

DECLARE @Products XML = '
<products>
    <product id="2" name="new 2" listPrice="22" />
    <product id="4" name="new 4" listPrice="44" />
    <product id="5" name="Product 5" listPrice="50" />
</products>'


MERGE INTO Products P
USING @Products.nodes('/products/product') T(c)
ON P.Id = c.value(
'@id', 'TINYINT')
WHEN MATCHED THEN
    UPDATE
    SET Name = c.value(
'@name', 'VARCHAR(10)'),
        ListPrice = c.value(
'@listPrice', 'DECIMAL(8, 2)')
WHEN NOT MATCHED THEN
    INSERT (Id, Name, ListPrice)
    VALUES (c.value(
'@id', 'TINYINT'),
        c.value(
'@name', 'VARCHAR(10)'),
        c.value(
'@listPrice', 'DECIMAL(8, 2)')
    );


Si revisamos el contenido de la tabla Products veremos lo siguiente:


Vemos que los productos 2 y 4 fueron actualizados acorde a los valores que tenía nuestro documento XML y que el producto 5 fue agregado con los valores del documento XML.

Notemos que la sentencias UPDATE e INSERT no indican en qué tabla se van a ejecutar, para entenderlo recordemos que la tabla que aparece después de MERGE INTO es la tabla objetivo, por lo tanto es la tabla a la que apuntarán las sentencias establecidas en WHEN MATCHED y WHEN NOT MATCHED.

En la siguiente entrada exploraremos con más detalle la forma en cómo podemos operar con documentos XML, espero te resulte de ayuda esta entrada.